
AI 内存层级:Memory Wall、KV Cache、HBM、CXL 与 SSD
目录
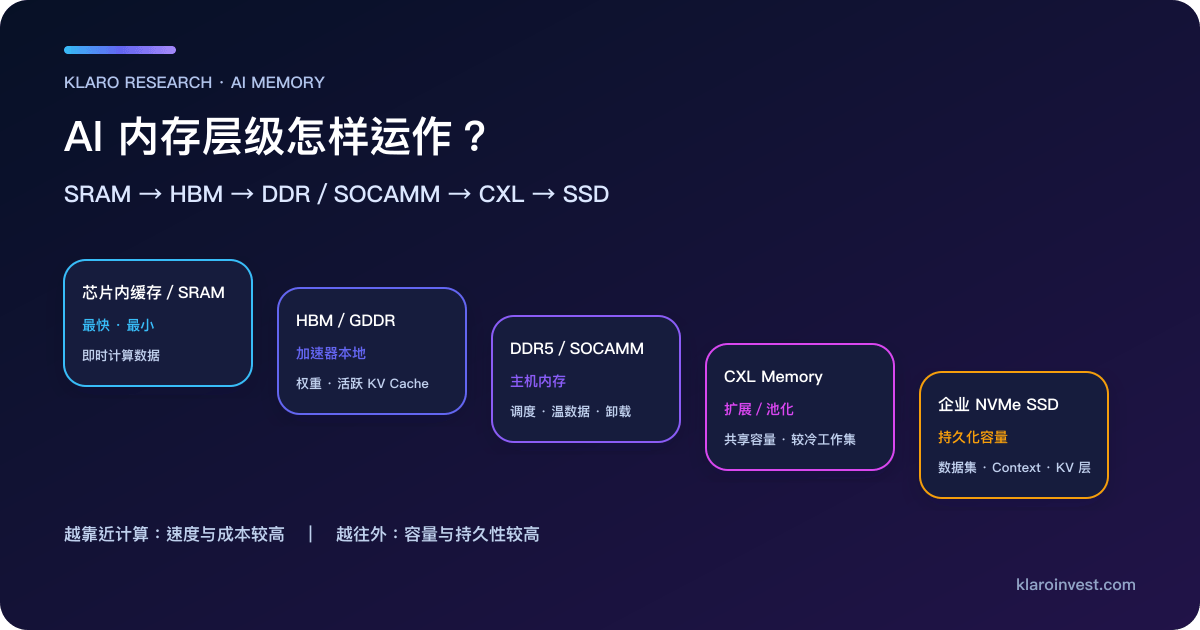
AI 内存阶层,是把模型权重、activation、KV Cache、资料集和检查点,按速度、容量、持久性及搬移成本分配到不同硬件。 靠近运算的 SRAM/cache 与 HBM 最快但容量有限;主机 DDR/SOCAMM、CXL 内存与企业 NVMe SSD 逐步增加容量和持久性,同时增加资料搬移延迟与软件管理要求。
Memory Wall(内存墙)并不等于「HBM 缺货」。它描述的是计算单元需要资料的速度、容量或能耗,跟不上模型工作负载。增加 GPU 算力后,如果权重或 KV Cache 不能及时进入运算单元,昂贵的计算核心仍会等待资料。
对投资者而言,真正的需求单位不是某一种内存的市场口号,而是资料在哪里、多久会重用、搬一次要付出多少时间和电力,以及供应商能否把产品变成部署、收入与现金。 本文证据截至 2026 年 9 月 2 日。
AI 内存阶层包含哪些硬件?
| 层级 | 常见硬件 | 主要保存资料 | 优势 | 主要代价 |
|---|---|---|---|---|
| 芯片内 | SRAM、register、L1/L2 cache | 正在运算的极热资料 | 最接近计算、延迟最低 | 面积与容量非常有限 |
| 加速器本地 | HBM、部分平台的 GDDR | 模型权重、activation、活跃 KV Cache | 高总带宽,可维持 GPU/ASIC 利用率 | 成本、功耗、封装面积、良率与固定容量 |
| 主机内存 | DDR5 RDIMM/MRDIMM、LPDDR5X SOCAMM | CPU 工作集、资料准备、暖 KV Cache、卸载权重 | 容量较大、模块化、CPU 可直接使用 | 与 GPU 之间仍有搬移成本 |
| 扩充/共享 | CXL-attached memory、remote DRAM | 较冷工作集、共享容量、资源池 | 扩充与 pooling,提高容量利用率 | 互连、NUMA、switch、软件放置与延迟 |
| 持久化存储 | 企业 NVMe SSD、网络/物件存储 | 资料集、checkpoint、模型档、context/较冷 KV blocks | 容量大、可持久保存、每 bit 成本较低 | 存取较慢、写入耐久与资料搬移要管理 |
NVIDIA Dynamo 的 KVBM 文件已把 KV blocks 分为 GPU、host、disk 和 object storage tiers,证明多层 cache 不只是概念;每层要先设定容量和 offload 规则,错误配置会因反复搬移而降低效能。[2]
图:常见 AI 推理资料阶层的概念图。资料越冷、重用时间越长,越可能移往容量较大的一层;实际配置必须以模型、互连和软件实测。
KV Cache 为什么会令 HBM 容量不足?
Transformer 推理会为已处理的 token 保存 attention 的 key 和 value 状态,后续生成新 token 时可以直接重用,避免每次重算完整前文。这组状态称为 KV Cache。
KV Cache 会随上下文长度、同时请求数、模型层数、hidden dimensions、attention 架构和资料精度改变。模型权重已占用一部分 HBM 后,剩余容量还要分给 KV Cache、activation、工作空间和通讯 buffer;长上下文与高并发因而可以在算力耗尽前先碰到容量限制。
NVIDIA Dynamo 把 KV Cache-aware routing、重用与 offloading 分开:有相同 prefix 的请求可重用 cache,较冷的 blocks 可以移到主机 DRAM、local disk 或 remote storage,减少重新计算。[1]
这个机制不保证 offload 一定更快。NVIDIA NIM 文件指出,host offload 能保留更多可重用 blocks,但 CPU–GPU 搬移仍有 overhead;互连较慢、cache 命中率太低或资料频繁来回时,搬移成本可能抵销收益。[3]
热、暖、冷资料应放在哪一层?
| 资料状态 | 放置原则 | 常见层级 | 需要验证的指标 |
|---|---|---|---|
| 正在每个 token 使用 | 优先保留带宽和最低搬移距离 | SRAM/cache、HBM/GDDR | tokens/second、GPU utilization、memory bandwidth |
| 近期很可能重用 | 容量与回载时间平衡 | HBM、host DDR/SOCAMM | cache hit rate、TTFT、host-to-device transfer |
| 跨请求或较长时间重用 | 只在命中收益高于搬移成本时保存 | host DRAM、CXL memory、NVMe SSD | 命中率、尾延迟、每 token 成本、SSD endurance |
| 长期保存 | 重视容量、持久性和资料管理 | NVMe、网络/物件存储 | throughput、availability、资料保护、总成本 |
NVIDIA 在 2026 年提出 CMX Context Memory Storage Platform,目标是把 agentic AI 的长上下文和 KV Cache 从一般持久化存储分出一个专用 context tier。这证明 SSD/网络层开始直接参与推理资料路径;其产品效能与商业采用仍要由正式部署、客户和收入验证。完整 NAND、controller、固件与供应商比较见 AI 企业 SSD。[4]
CXL Memory 解决的是带宽还是容量?
CXL 包含 CXL.io、CXL.cache 和 CXL.mem。CXL.mem 让 host 或装置以一致性方法接触 device-attached memory;较新的规格亦支持 switching、sharing 和 memory pooling,使容量可以跨系统更灵活分配。[5]
CXL 主要改善容量、利用率和资源配置,不能把较远的 memory pool 变成 GPU 封装内的 HBM。资料离计算愈远,便愈依赖互连、switch、拓扑和软件把正确页面放在正确节点。若工作负载需要每个 token 反复读取同一资料,HBM 仍更接近问题;若大量容量只在少数时刻使用,CXL 的共享价值才较高。
投资者研究 CXL 时应把证据分成四级:
- protocol/IP 支持;
- controller 或 switch 产品;
- OEM 平台与软件整合;
- 客户部署、收入与现金。
Astera Labs和 Marvell已提供相关连接产品,但产品发布不能直接等同 CXL memory pooling 已形成大规模收入。
SOCAMM2、MRDIMM 与 DDR5 RDIMM 怎样分工?
截至 2026 年 9 月 2 日,DDR5 RDIMM 是成熟服务器主机内存;MRDIMM 通过 multiplexing 提高内存子系统资料率;SOCAMM2 则把 LPDDR5X 的低功耗与较小 form factor 带到可更换的服务器模块。三者都属主机/系统内存选择,不是 HBM 的同位置替代品。
AMD 截至 2026 年 4 月 6 日的资料指出,DDR5 RDIMM 仍会是一般用途服务器的重要标准;SOCAMM2 的吸引力在功耗、密度和水平安装,现阶段 RAS 功能与适用工作负载仍要追上成熟 RDIMM。AMD 计划在 2027 年部分 EPYC 平台支持 LPDDR5X SOCAMM2。[6]
Micron 与 SK hynix 都把 SOCAMM2、HBM 和企业 SSD 放入 AI 内存组合,支持「多层同时增长」的产业方向。这些公司资料首先证明产品布局;真正的收入证据仍要核对客户平台、样品、认证、量产、bit 出货与产品 mix。[7] [8]
训练与推理对内存的需求有何不同?
训练需要保存权重、activation、gradient、optimizer state 和 checkpoint,并在多个加速器之间高频交换;HBM 容量、带宽、GPU interconnect 和网络共同控制吞吐。推理的 prefill 偏重计算,decode 经常受权重与 KV Cache 搬移限制;长上下文、高并发和 prefix reuse 令多层 cache 更重要。
| 工作负载 | 最容易先受限 | 阶层设计重点 |
|---|---|---|
| 大模型训练 | HBM 容量/带宽、加速器互连、checkpoint I/O | 保持资料并行与高 GPU 利用率,缩短 checkpoint 停顿 |
| 高吞吐推理 | 权重读取、HBM 带宽、batch 与排程 | 在 TTFT、tokens/second 和并发之间平衡 |
| 长上下文/agentic AI | KV Cache 容量、重用、回载与持久性 | HBM 热层+host/SSD 暖冷层,按命中率搬移 |
| RAG/embedding | index、向量资料、网络与 SSD I/O | 将资料检索与模型执行分开量度 |
更完整的 prefill/decode 与芯片架构差异见 AI 训练 vs 推理及 AI 推理芯片。
哪些上市公司对应每一层需求?
| 需求层 | 代表公司或产业 | 收入前必须出现的证据 |
|---|---|---|
| 加速器与片上 cache | NVIDIA、AMD、ASIC/IP 供应商 | 芯片出货、平台利用率、软件采用与毛利 |
| HBM/GDDR | Samsung、SK hynix、Micron | 客户认证、合格出货、stack 良率、产品收入与现金 |
| DDR/SOCAMM/MRDIMM | Samsung、SK hynix、Micron | 服务器平台支持、容量 mix、bit 出货、ASP 与库存 |
| CXL controller/switch/memory | Astera Labs、Marvell、内存原厂与 IP 供应商 | OEM 设计、量产部署、收入披露,不只协定支持 |
| NAND/企业 SSD | Samsung、SK hynix/Solidigm、Micron、Sandisk及 Kioxia | 客户认证、容量出货、controller/固件、ASP、毛利与 CFO |
同一公司可以横跨多层,收入纯度仍由实际业务组合决定。Samsung 有手机、Foundry 与显示业务;SK hynix、Micron 较集中于内存,仍同时受 DRAM/NAND 周期影响;Sandisk 和 Kioxia 主要位于 NAND/SSD 层,HBM/DRAM 则由三大综合内存原厂主导。
投资者怎样判断真正的 AI 内存受益?
把产业叙事转成公司研究,可以依次核对:
工作负载是否真的受内存限制
→ 哪一层是容量/带宽/持久性瓶颈
→ 新产品是否完成平台认证
→ 是否开始合格、可重复出货
→ 产品 mix 与 ASP 是否进入收入和毛利
→ 库存、应收、CFO 与 CapEx 是否形成股东现金
若只有 benchmark,证明的是指定配置可行;若只有产品公告,证明的是供应商准备参与;若已有客户部署但没有分部披露,仍不能量化收入纯度。Klaro 的 内存周期可继续核对价格、库存与产能,HBM 供应链则把 DRAM 晶粒、堆叠、base die、封装与测试拆开。
常见问题:Memory Wall、KV Cache 与 CXL
Memory Wall 和程式设计的 memory barrier 是同一概念吗? 不是。Memory Wall 描述计算与内存带宽/容量/延迟之间的系统瓶颈;memory barrier 是控制处理器或编译器内存操作顺序的同步机制。
KV Cache 一定要放在 HBM 吗? 正在生成 token、频繁读取的 KV blocks 通常适合留在 HBM。可重用但较冷的 blocks 可以卸载至 host DRAM、CXL memory 或 SSD;是否划算取决于命中率、互连和回载成本。
CXL 可以取代 HBM 吗? CXL 主要提供一致性连接、扩充与 pooling;它增加可用容量,没有把远端 memory 的物理距离、带宽和延迟变成加速器本地 HBM。
SOCAMM2 是否会取代 DDR5 RDIMM? 较准确的判断是按场景并存。SOCAMM2 强调低功耗、密度与模块化,成熟 RDIMM 则有一般服务器生态和 RAS 优势;平台支持与正式部署会决定各自适用范围。
SSD 进入 KV Cache 是否等于所有 NAND 公司都受益? 不是。SSD 要先符合延迟、吞吐、耐久、controller、固件和软件要求,再由部署规模、出货、ASP、毛利和现金证明公司捕捉。企业 SSD 的公司与供应链需要独立比较。
Klaro Research
资料来源与更新依据
资料截止:2026年9月2日
- [1] NVIDIA NVIDIA Dynamo 架构与 KV Cache offloading
第一方 · 原始资料 · 查阅:2026年9月2日
- [2] NVIDIA Dynamo KVBM cache tiers 设定文件
第一方 · 原始资料 · 查阅:2026年9月2日
- [3] NVIDIA NIM KV Cache reuse 与 host offload
第一方 · 原始资料 · 查阅:2026年9月2日
- [4] NVIDIA BlueField-4 CMX Context Memory Storage Platform
第一方 · 原始资料 · 发布:2026年3月16日 · 查阅:2026年9月2日
- [5] Compute Express Link Consortium CXL 101:CXL.cache、CXL.mem、扩充与 pooling
权威资料 · 原始资料 · 查阅:2026年9月2日
- [6] AMD LPDDR5X SOCAMM2 的服务器能效、模块化与 RAS 边界
第一方 · 原始资料 · 发布:2026年4月6日 · 查阅:2026年9月2日
- [7] Micron Technology AI 数据中心 HBM、系统内存与 SSD 产品地图
第一方 · 原始资料 · 查阅:2026年9月2日
- [8] SK hynix HBM、SOCAMM2 与 eSSD 的 AI 内存阶层
第一方 · 原始资料 · 发布:2026年7月3日 · 查阅:2026年9月2日
研究限制
- 五层图是用于投资研究的概念架构;实际系统可省略、合并、平行或远端部署某些层,不应由图形位置推算延迟与带宽。
- KV Cache 容量与卸载效益取决于模型架构、上下文、batch、重用率、互连、存储和软件;没有跨平台固定的每 token 成本。
- 厂商规格与 benchmark 只证明指定平台能力,不能直接推导市场份额、收入、毛利或股票回报。
需要重新检查的事件
- NVIDIA CMX/Dynamo、主要推理框架或云端平台公布量产部署与 KV Cache tiering 实测,改变 HBM/DRAM/SSD 边界时更新。
- CXL memory pooling、SOCAMM2/MRDIMM 或 High Bandwidth Flash 取得大规模商用与收入证据时重核产业映射。
本文仅供参考,不构成投资建议。