
AI 記憶體階層:Memory Wall、KV Cache、HBM、CXL 與 SSD
目錄
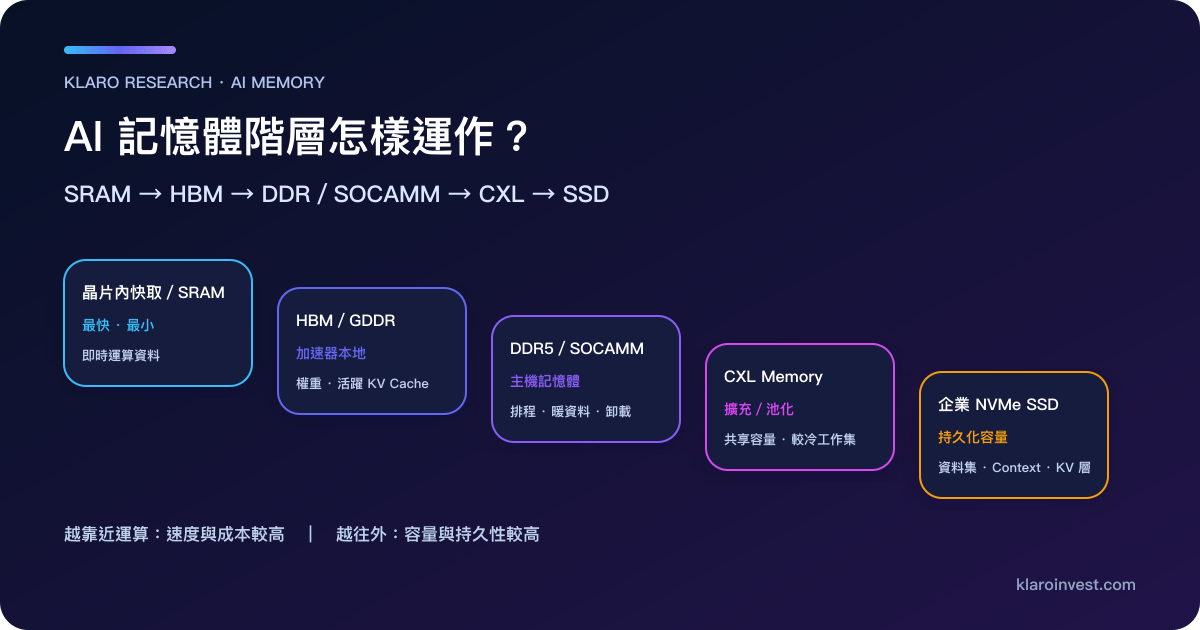
AI 記憶體階層,是把模型權重、activation、KV Cache、資料集和檢查點,按速度、容量、持久性及搬移成本分配到不同硬件。 靠近運算的 SRAM/cache 與 HBM 最快但容量有限;主機 DDR/SOCAMM、CXL 記憶體與企業 NVMe SSD 逐步增加容量和持久性,同時增加資料搬移延遲與軟件管理要求。
Memory Wall(記憶體牆)描述資料供應相對計算需求的限制,可能出現在頻寬、延遲、容量或搬移能耗。GPU算力提高後,權重及KV Cache仍需及時到達運算單元,才能維持計算資源的利用率。
投資者應沿資料所在位置、重用頻率及搬移成本,核對硬件如何形成可用部署、收入與現金。階層及KV Cache文件採各自標示版本;本次SOCAMM/RDIMM商業證據補充核對截至2026年10月11日。
AI 記憶體階層包含哪些硬件?
| 層級 | 常見硬件 | 主要保存資料 | 優勢 | 主要代價 |
|---|---|---|---|---|
| 晶片內 | SRAM、register、L1/L2 cache | 正在運算的極熱資料 | 最接近計算、延遲最低 | 面積與容量非常有限 |
| 加速器本地 | HBM、部分平台的 GDDR | 模型權重、activation、活躍 KV Cache | 高總頻寬,可維持 GPU/ASIC 利用率 | 成本、功耗、封裝面積、良率與固定容量 |
| 主機記憶體 | DDR5 RDIMM/MRDIMM、LPDDR5X SOCAMM | CPU 工作集、資料準備、暖 KV Cache、卸載權重 | 容量較大、模組化、CPU 可直接使用 | 與 GPU 之間仍有搬移成本 |
| 擴充/共享 | CXL-attached memory、remote DRAM | 較冷工作集、共享容量、資源池 | 擴充與 pooling,提高容量利用率 | 互連、NUMA、switch、軟件放置與延遲 |
| 持久化儲存 | 企業 NVMe SSD、網絡/物件儲存 | 資料集、checkpoint、模型檔、context/較冷 KV blocks | 容量大、可持久保存、每 bit 成本較低 | 存取較慢、寫入耐久與資料搬移要管理 |
NVIDIA Dynamo 的 KVBM 文件已把 KV blocks 分為 GPU、host、disk 和 object storage tiers,證明多層 cache 不只是概念;每層要先設定容量和 offload 規則,錯誤配置會因反覆搬移而降低效能。[2]
圖:常見 AI 推理資料階層的概念圖。資料越冷、重用時間越長,越可能移往容量較大的一層;實際配置必須以模型、互連和軟件實測。
KV Cache 為甚麼會令 HBM 容量不足?
Transformer 推理會為已處理的 token 保存 attention 的 key 和 value 狀態,後續生成新 token 時可以直接重用,避免每次重算完整前文。這組狀態稱為 KV Cache。
KV Cache 會隨上下文長度、同時請求數、模型層數、hidden dimensions、attention 架構和資料精度改變。模型權重已佔用一部分 HBM 後,剩餘容量還要分給 KV Cache、activation、工作空間和通訊 buffer;長上下文與高併發因而可以在算力耗盡前先碰到容量限制。
NVIDIA Dynamo 把 KV Cache-aware routing、重用與 offloading 分開:有相同 prefix 的請求可重用 cache,較冷的 blocks 可以移到主機 DRAM、local disk 或 remote storage,減少重新計算。[1]
這個機制不保證 offload 一定更快。NVIDIA NIM 文件指出,host offload 能保留更多可重用 blocks,但 CPU–GPU 搬移仍有 overhead;互連較慢、cache 命中率太低或資料頻繁來回時,搬移成本可能抵銷收益。[3]
熱、暖、冷資料應放在哪一層?
資料進入持久儲存後,活躍讀取與長期保留有不同的容量和性能要求。AI資料中心儲存產業把企業SSD、HDD及公司敞口分開;HDD vs企業SSD則比較每TB成本、IOPS、延遲與混合配置。
| 資料狀態 | 放置原則 | 常見層級 | 需要驗證的指標 |
|---|---|---|---|
| 正在每個 token 使用 | 優先保留頻寬和最低搬移距離 | SRAM/cache、HBM/GDDR | tokens/second、GPU utilization、memory bandwidth |
| 近期很可能重用 | 容量與回載時間平衡 | HBM、host DDR/SOCAMM | cache hit rate、TTFT、host-to-device transfer |
| 跨請求或較長時間重用 | 只在命中收益高於搬移成本時保存 | host DRAM、CXL memory、NVMe SSD | 命中率、尾延遲、每 token 成本、SSD endurance |
| 長期保存 | 重視容量、持久性和資料管理 | NVMe、網絡/物件儲存 | throughput、availability、資料保護、總成本 |
NVIDIA 在 2026 年提出 CMX Context Memory Storage Platform,目標是把 agentic AI 的長上下文和 KV Cache 從一般持久化儲存分出一個專用 context tier。這證明 SSD/網絡層開始直接參與推理資料路徑;其產品效能與商業採用仍要由正式部署、客戶和收入驗證。完整 NAND、controller、韌體與供應商比較見 AI 企業 SSD。[4]
CXL Memory 解決的是頻寬還是容量?
CXL 包含 CXL.io、CXL.cache 和 CXL.mem。CXL.mem 讓 host 或裝置以一致性方法接觸 device-attached memory;較新的規格亦支援 switching、sharing 和 memory pooling,使容量可以跨系統更靈活分配。[5]
CXL 主要改善容量、利用率和資源配置,不能把較遠的 memory pool 變成 GPU 封裝內的 HBM。資料離計算愈遠,便愈依賴互連、switch、拓撲和軟件把正確頁面放在正確節點。若工作負載需要每個 token 反覆讀取同一資料,HBM 仍更接近問題;若大量容量只在少數時刻使用,CXL 的共享價值才較高。
投資者研究 CXL 時應把證據分成四級:
- protocol/IP 支援;
- controller 或 switch 產品;
- OEM 平台與軟件整合;
- 客戶部署、收入與現金。
Astera Labs和 Marvell已提供相關連接產品,但產品發布不能直接等同 CXL memory pooling 已形成大規模收入。
SOCAMM2、MRDIMM 與 DDR5 RDIMM 怎樣分工?
按截至2026年10月11日核對的平台及產品資料,DDR5 RDIMM提供成熟伺服器主機記憶體,MRDIMM透過multiplexing提高記憶體子系統資料率,SOCAMM2則把LPDDR5X低功耗DRAM放入可更換的伺服器模組。比較時應固定平台、可用容量、通道、能耗與RAS,並把主機層放回GPU與儲存之間。[6]
截至2026年10月11日核對,AMD在2026年4月6日規劃,2027年的部分第六代EPYC平台將支援LPDDR5X SOCAMM2;成熟RDIMM的RAS生態與指定新平台功能需各自核對。[6]
商業證據亦已增加:Micron在9月30日公布的FY2026 Q4結果披露,伺服器LPDDR SOCAMM組合收入按季超過翻倍,同時有新容量及高速RDIMM的送樣與客戶資格。這是產品組合進展,個別容量的收入和毛利仍需後續披露。[9]
完整SOCAMM2與DDR5 RDIMM比較進一步拆解模組介面、平台、RAS及KV Cache測試分母。Micron與SK hynix的既有AI記憶體產品地圖,則繼續提供主機DRAM、HBM及SSD的分層角色。[7] [8]
訓練與推理對記憶體的需求有何不同?
訓練需要保存權重、activation、gradient、optimizer state 和 checkpoint,並在多個加速器之間高頻交換;HBM 容量、頻寬、GPU interconnect 和網絡共同控制吞吐。推理的 prefill 偏重計算,decode 經常受權重與 KV Cache 搬移限制;長上下文、高併發和 prefix reuse 令多層 cache 更重要。
| 工作負載 | 最容易先受限 | 階層設計重點 |
|---|---|---|
| 大模型訓練 | HBM 容量/頻寬、加速器互連、checkpoint I/O | 保持資料並行與高 GPU 利用率,縮短 checkpoint 停頓 |
| 高吞吐推理 | 權重讀取、HBM 頻寬、batch 與排程 | 在 TTFT、tokens/second 和併發之間平衡 |
| 長上下文/agentic AI | KV Cache 容量、重用、回載與持久性 | HBM 熱層+host/SSD 暖冷層,按命中率搬移 |
| RAG/embedding | index、向量資料、網絡與 SSD I/O | 將資料檢索與模型執行分開量度 |
更完整的prefill/decode機制見AI訓練 vs 推理;若要研究哪些運算平台採用不同記憶體配置,可接續AI推理概念股與晶片公司地圖,再以GPU vs ASIC核對工作負載、軟件與總成本。
哪些上市公司對應每一層需求?
| 需求層 | 代表公司或產業 | 收入前必須出現的證據 |
|---|---|---|
| 加速器與片上 cache | NVIDIA、AMD、ASIC/IP 供應商 | 晶片出貨、平台利用率、軟件採用與毛利 |
| HBM/GDDR | Samsung、SK hynix、Micron | 客戶認證、合格出貨、stack 良率、產品收入與現金 |
| DDR/SOCAMM/MRDIMM | Samsung、SK hynix、Micron | 伺服器平台支援、容量 mix、bit 出貨、ASP 與庫存 |
| CXL controller/switch/memory | Astera Labs、Marvell、記憶體原廠與 IP 供應商 | OEM 設計、量產部署、收入披露,不只協定支援 |
| NAND/企業 SSD | Samsung、SK hynix/Solidigm、Micron、Sandisk及 Kioxia | 客戶認證、容量出貨、controller/韌體、ASP、毛利與 CFO |
同一公司可以橫跨多層,收入純度仍由實際業務組合決定。Samsung 有手機、Foundry 與顯示業務;SK hynix、Micron 較集中於記憶體,仍同時受 DRAM/NAND 周期影響;Sandisk 和 Kioxia 主要位於 NAND/SSD 層,HBM/DRAM 則由三大綜合記憶體原廠主導。
投資者怎樣判斷真正的 AI 記憶體受惠?
把產業敘事轉成公司研究,可以依次核對:
工作負載是否真的受記憶體限制
→ 哪一層是容量/頻寬/持久性瓶頸
→ 新產品是否完成平台認證
→ 是否開始合格、可重複出貨
→ 產品 mix 與 ASP 是否進入收入和毛利
→ 庫存、應收、CFO 與 CapEx 是否形成股東現金
若只有 benchmark,證明的是指定配置可行;若只有產品公告,證明的是供應商準備參與;若已有客戶部署但沒有分部披露,仍不能量化收入純度。Klaro 的 記憶體週期可繼續核對價格、庫存與產能,HBM 供應鏈則把 DRAM 晶粒、堆疊、base die、封裝與測試拆開。
常見問題
Memory Wall 和程式設計的 memory barrier 是同一概念嗎? 不是。Memory Wall 描述計算與記憶體頻寬/容量/延遲之間的系統瓶頸;memory barrier 是控制處理器或編譯器記憶體操作順序的同步機制。
KV Cache 一定要放在 HBM 嗎? 正在生成 token、頻繁讀取的 KV blocks 通常適合留在 HBM。可重用但較冷的 blocks 可以卸載至 host DRAM、CXL memory 或 SSD;是否划算取決於命中率、互連和回載成本。
CXL 可以取代 HBM 嗎? CXL 主要提供一致性連接、擴充與 pooling;它增加可用容量,沒有把遠端 memory 的物理距離、頻寬和延遲變成加速器本地 HBM。
SOCAMM2 是否會取代 DDR5 RDIMM? 較準確的判斷是按場景並存。SOCAMM2 強調低功耗、密度與模組化,成熟 RDIMM 則有一般伺服器生態和 RAS 優勢;平台支援與正式部署會決定各自適用範圍。
SSD 進入 KV Cache 是否等於所有 NAND 公司都受惠? 不是。SSD 要先符合延遲、吞吐、耐久、controller、韌體和軟件要求,再由部署規模、出貨、ASP、毛利和現金證明公司捕捉。企業 SSD 的公司與供應鏈需要獨立比較。
Klaro Research
資料來源與更新依據
資料截止:2026年10月11日
- [1] NVIDIA NVIDIA Dynamo 架構與 KV Cache offloading
第一方 · 原始資料 · 查閲:2026年9月2日
- [2] NVIDIA Dynamo KVBM cache tiers 設定文件
第一方 · 原始資料 · 查閲:2026年9月2日
- [3] NVIDIA NIM KV Cache reuse 與 host offload
第一方 · 原始資料 · 查閲:2026年9月2日
- [4] NVIDIA BlueField-4 CMX Context Memory Storage Platform
第一方 · 原始資料 · 發佈:2026年3月16日 · 查閲:2026年9月2日
- [5] Compute Express Link Consortium CXL 101:CXL.cache、CXL.mem、擴充與 pooling
權威資料 · 原始資料 · 查閲:2026年9月2日
- [6] AMD LPDDR5X SOCAMM2 的伺服器能效、模組化與 RAS 邊界
第一方 · 原始資料 · 發佈:2026年4月6日 · 查閲:2026年9月2日
- [7] Micron Technology AI 資料中心 HBM、系統記憶體與 SSD 產品地圖
第一方 · 原始資料 · 查閲:2026年9月2日
- [8] SK hynix HBM、SOCAMM2 與 eSSD 的 AI 記憶體階層
第一方 · 原始資料 · 發佈:2026年7月3日 · 查閲:2026年9月2日
- [9] Micron FY2026 Q4及全年結果:SOCAMM組合與RDIMM
第一方 · 財報 · 截至2026-09-03季度;2026-09-30公布 · 發佈:2026年9月30日 · 查閲:2026年10月11日
研究限制
- 五層圖是用於投資研究的概念架構;實際系統可省略、合併、平行或遠端部署某些層,不應由圖形位置推算延遲與頻寬。
- KV Cache 容量與卸載效益取決於模型架構、上下文、batch、重用率、互連、儲存和軟件;沒有跨平台固定的每 token 成本。
- 廠商規格與 benchmark 只證明指定平台能力,不能直接推導市場份額、收入、毛利或股票回報。
需要重新檢查的事件
- NVIDIA CMX/Dynamo、主要推理框架或雲端平台公布量產部署與 KV Cache tiering 實測,改變 HBM/DRAM/SSD 邊界時更新。
- CXL memory pooling、SOCAMM2/MRDIMM 或 High Bandwidth Flash 取得大規模商用與收入證據時重核產業映射。
本文僅供參考,不構成投資建議。